
텍스트 영상일까 이미지 영상일까, 입력 모드부터
게시일 2026년 10월 24일 업데이트 2026년 10월 24일 9 분 읽기
스틸과 얼굴·패키지로 text-to-video와 image-to-video를 고릅니다. 텍스트, first frame, 시작·끝에 맞춥니다.
텍스트로 영상을 만들까, 이미지로 영상을 만들까. 먼저 승인된 스틸이 있는지 봅니다. 없으면 텍스트만(text-to-video / t2v)으로 구도를 시험하고, 있으면 첫 프레임(image-to-video / i2v, first frame)으로 외형을 잠근 다음 움직임을 넣어요. 시작과 끝이 정해져 있거나 샷을 건너 같은 인물·같은 패키지가 필요하면 시작+끝이나 멀티모달 참조(r2v)로 올립니다. 입력 모드를 잘못 고르면 모델 이름을 잘못 고른 것보다 재생성 비용이 커요. Sora2 AI에서도 순서는 같습니다.
한 표로 고르기
| 시작점 | 우선 모드 | 프롬프트에 쓸 것 | 흔한 실패 |
|---|---|---|---|
| 글 아이디어만 | 텍스트만 (t2v) | 주체, 동작, 장면, 카메라 한 가지, 길이 | 스타일 단어만 있고 동사가 없음 |
| 확정된 제품·인물 컷 | 첫 프레임 (i2v) | 어떻게 움직이는지, 카메라가 어떻게 가는지 | 외모를 다시 써서 스틸과 충돌 |
| 오프닝과 마무리가 이미 있음 | 시작 + 끝 | 사이의 전환과 리듬 | 화면비가 너무 다름, 움직임을 최대로 |
| 샷 사이 같은 정체성 | 멀티모달 참조 (r2v) | 참조를 분명히, 한 번에 변수 종류는 하나 | 참조가 흩어짐, 전경이 붐빔 |
기준은 이거예요. 찾을 때는 텍스트, 승인본과 같아야 하면 이미지거나 참조.
텍스트 영상: 언제, 어떻게
서사 훅, 분위기 샷, 의상이 정해지기 전의 콘셉트, 스토리보드 초안에 맞아요.
다섯 덩어리로 씁니다. 주체 → 동작 → 장면 → 카메라 → 길이의 용도. 초고는 주 카메라 하나, 길이는 파라미터와 맞춥니다. 자세한 내용은 카메라 움직임과 길이에 있어요.
이미지 영상: 언제, 어떻게
제품 오프닝, 룩이 정해진 뒤 움직이는 캐릭터, 고객이 승인한 패키지 스틸, 움직이는 포스터에 맞아요.
「빨간 도자기 주전자의 생김새」를 반복하지 말고 「천천히 회전, 김이 오름, 가벼운 푸시인」을 쓰세요. 주체는 선명하게, 배경은 조용히. 정체성을 지키는 법은 참조 프레임 일관성에 있습니다.
시작+끝과 멀티모달은 첫 프레임과 섞지 않기
- 시작과 끝은 시간축 양쪽을 고정합니다. 이미 아는 전환에 맞아요. 비율이 다르면 많은 파이프라인이 첫 프레임 기준으로 자릅니다.
- 멀티모달 참조가 답하는 것은 「누구 / 어떤 스타일」이지, 시간의 한 시작점이 아니에요. 여러 장을 올릴 때는 첫 문장에서 주 참조를 지목하세요.
- 서로 싸우는 first frame 조건과 상관없는 참조 묶음을 한 작업에 넣지 마세요. 입력 계약은 하나로 정합니다.
재생성을 줄이는 순서
- 승인 스틸이 있는지, 샷 사이 정체성이 필요한지 정합니다.
- 모드를 고른 다음 프롬프트를 씁니다(지울 문장은 모드가 알려 줘요).
- 카메라 연출이나 해상도를 올리기 전에 짧은 길이로 통과시킵니다.
- 얼굴과 패키지는 「스틸 → 이미지 영상」을 우선하고, 텍스트를 연달아 돌려 얼굴을 걸지 않습니다.
- 유료 매체 전에 상용 점검표를 봅니다.
정리
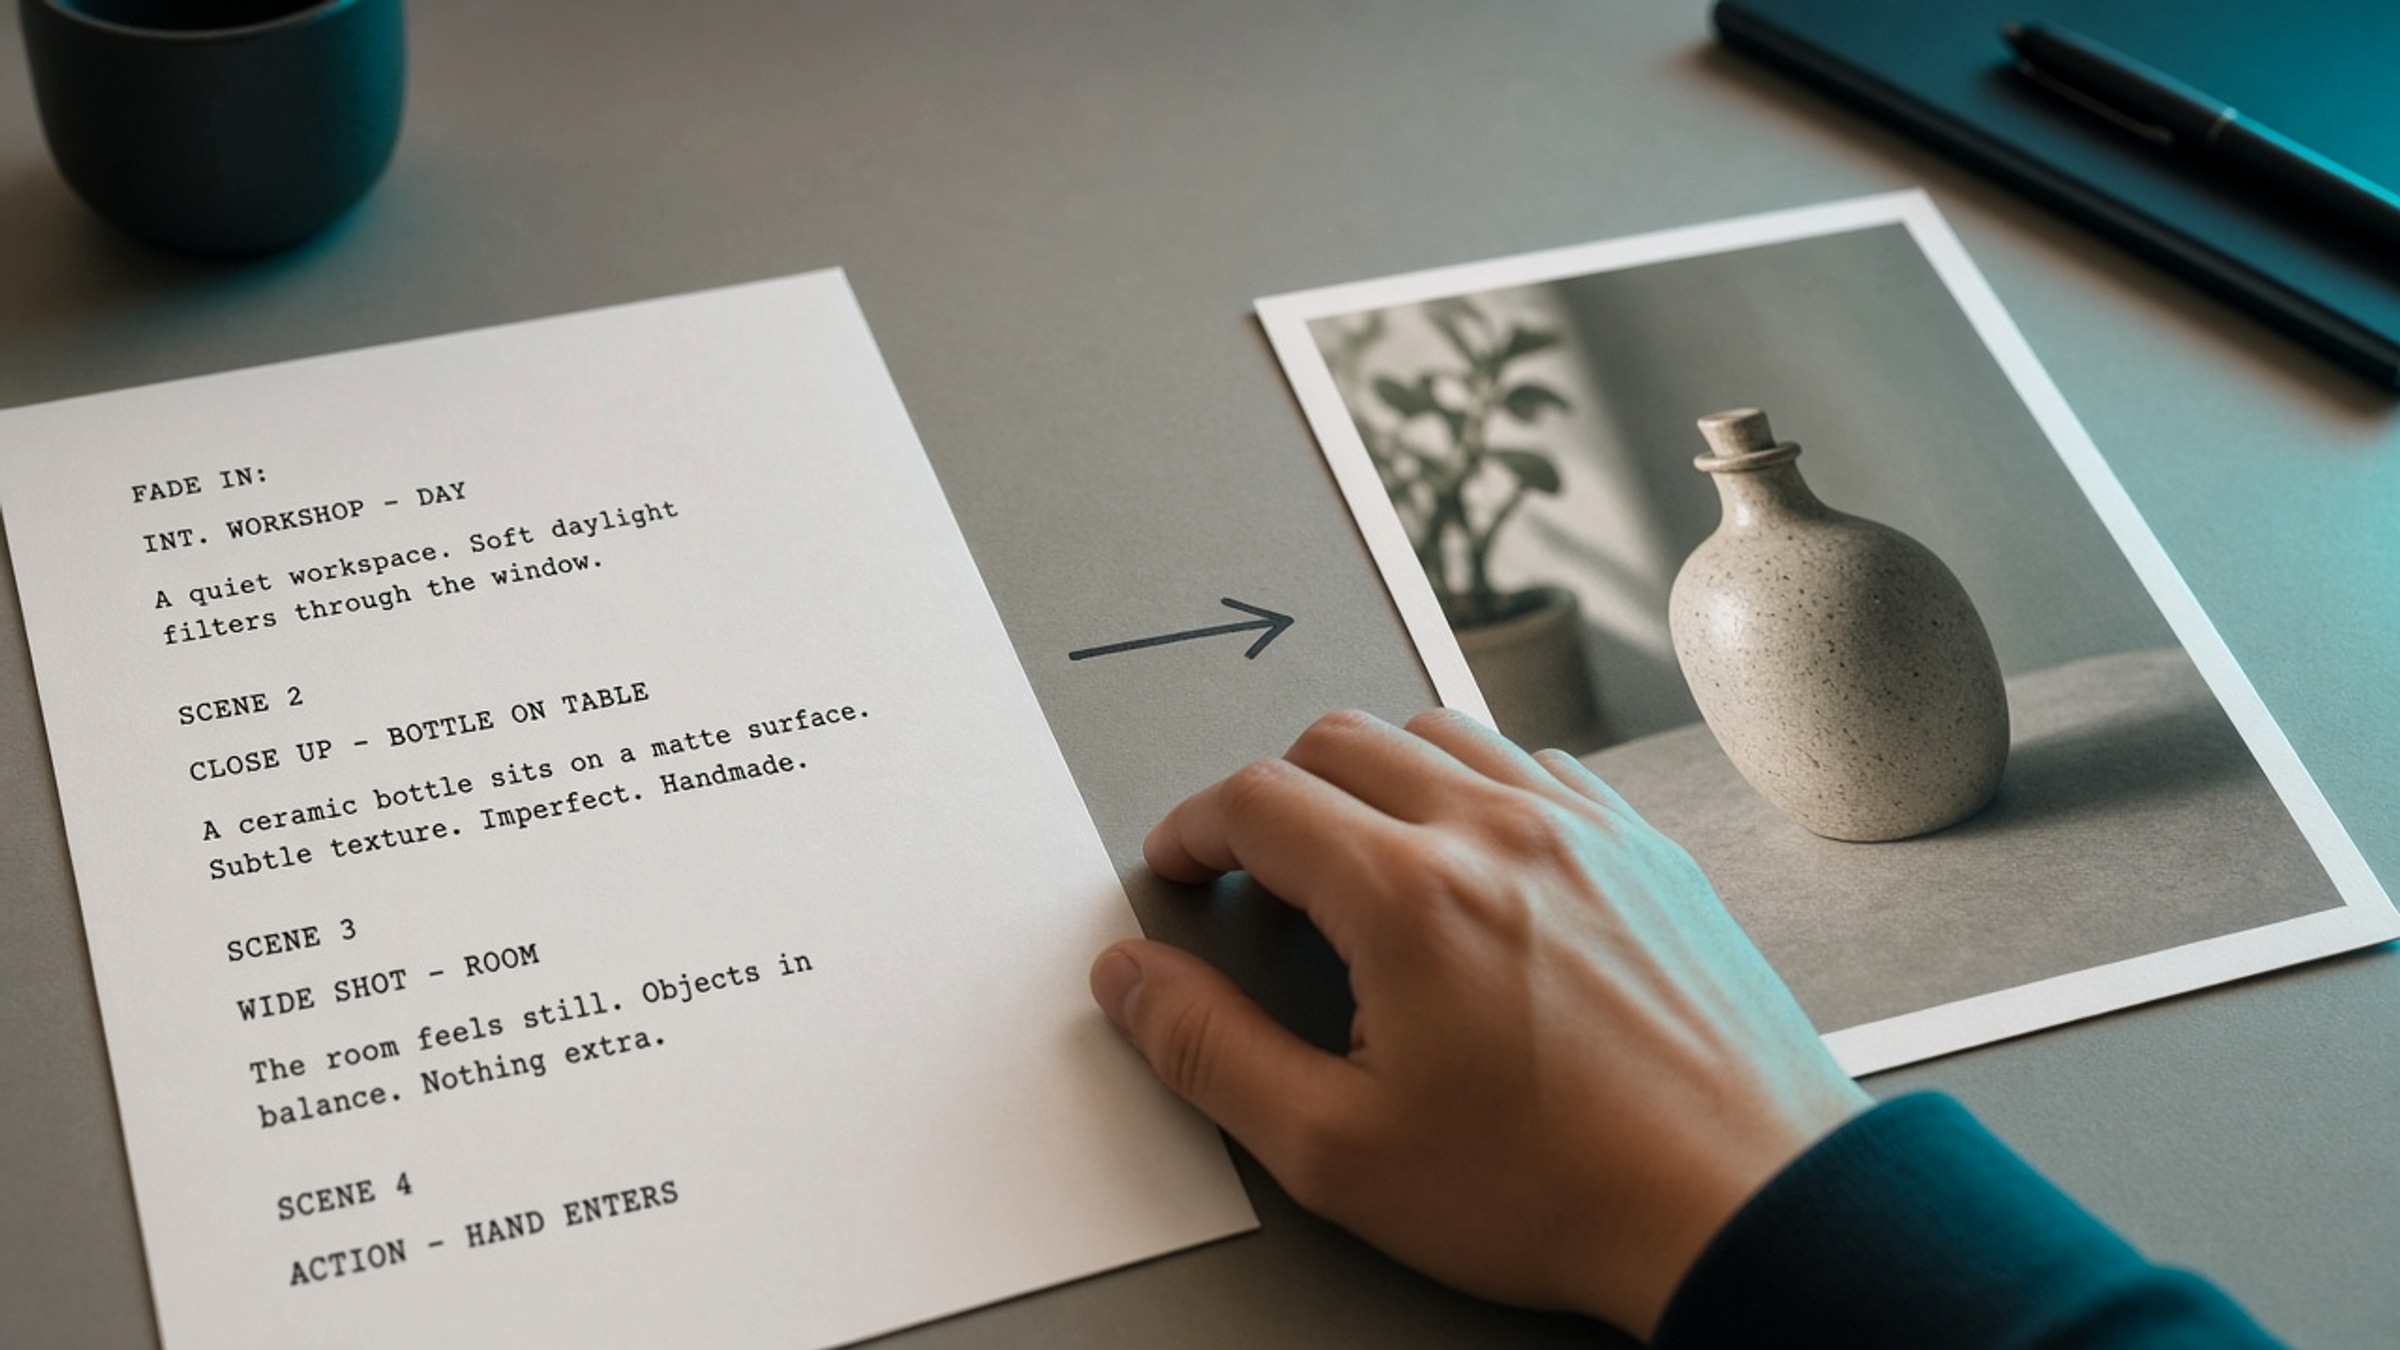
텍스트 영상은 없는 곳에서 만들고, 이미지 영상은 있는 외형을 움직입니다. 시작+끝과 멀티모달 참조는 전환과 정체성을 맡아요. 입력 모드를 먼저 고른 뒤, 작업으로 계열 고르기는 Seedance·Wan·Kling 고르는 법을 보세요. 다시 뽑는 횟수가 줄어듭니다.
자주 묻는 질문
텍스트 영상과 이미지 영상의 핵심 차이는 뭔가요?
Text-to-video(텍스트만 / t2v)는 프롬프트로 샷 전체를 만듭니다. Image-to-video(first frame / i2v)는 이미 잠근 스틸에 움직임을 붙입니다. 전자는 탐색이 빠르고, 후자는 외형을 더 잘 붙잡아요.
순수 텍스트 대신 첫 프레임이 꼭 필요한 때는요?
샷을 건너 같은 얼굴, 같은 패키지, 같은 로고 위치가 버텨야 하거나 스틸이 이미 승인됐을 때예요. 순수 텍스트는 콘셉트 영상과 스토리보드 초안에 맞아요.
첫 프레임과 시작+끝은 어떻게 가르나요?
「이 그림에서 이어 가라」면 first frame. 시작과 끝이 알려져 있으면(낮에서 해 질 녘, 뚜껑 열림에서 닫힘) 시작+끝. 화면비는 보통 첫 프레임을 따라요.
멀티모달 참조(r2v)는 첫 프레임과 같은 건가요?
아니에요. First frame은 시간축의 시작을 잠급니다. 멀티모달 참조는 여러 자료로 정체성이나 스타일을 샷 사이에 붙들어요. 한도는 그 모델의 현재 능력을 따릅니다.
이미지 영상 프롬프트에 외모를 또 써야 하나요?
보통은 쓰지 않아요. 그림이 이미 모습을 담고 있어요. 동작, 카메라, 빛 변화, 길이의 용도를 써서 스틸과 싸우지 않게 하세요.
한 클립 길이는 얼마나 잡아야 안정적인가요?
짧은 길이에서 주체가 무너지지 않는지 확인한 뒤 늘리세요. 많은 샷은 최대 길이보다 4–8초가 더 안정적이에요. 긴 이야기는 클립을 이어 붙입니다.
공유
관련 게시물
AI 영상 얼굴 드리프트, 증상별로 고치기
AI 영상 얼굴 드리프트 고치는 법: 클립 안·클립 사이·옆얼굴·가림 후 증상으로 나눈 뒤 참조 이미지·길이·동작을 한 종류만 조정하세요. 대조표로 원인을 빠르게 찾습니다.
작업 흐름Sora2 AI 참조 프레임: 인물·제품 외형 맞추기
Sora2 AI에서 인물·제품 일관성 유지. 첫/끝 프레임 사용 시점, 참조 이미지 선택, 변수는 한 번에 하나만 변경. 사이트 스튜디오에서 바로 시험해 보는 실전 메모입니다.
작업 흐름Seedance·Wan·Kling 고르는 법: 작업으로 계열 정하기
Seedance·Wan·Kling 고르는 법. 긴 원테이크·음성 숏·시작·끝 프레임·멀티모달 참조로 세 계열을 나눕니다. 작업부터 정한 뒤 모델 페이지에서 한도를 확인하세요.