
文生影片還是圖生影片?依素材一次選對輸入模式
發布於 2026年10月24日 更新於 2026年10月24日 9 分鐘閱讀
手邊沒有定稿靜幀就用文生影片試構圖;已有產品或人物圖就走首幀鎖外形。跨鏡頭再對照首尾幀與多模態參考,輸入模式先選定,少走重抽,也別重寫外貌。
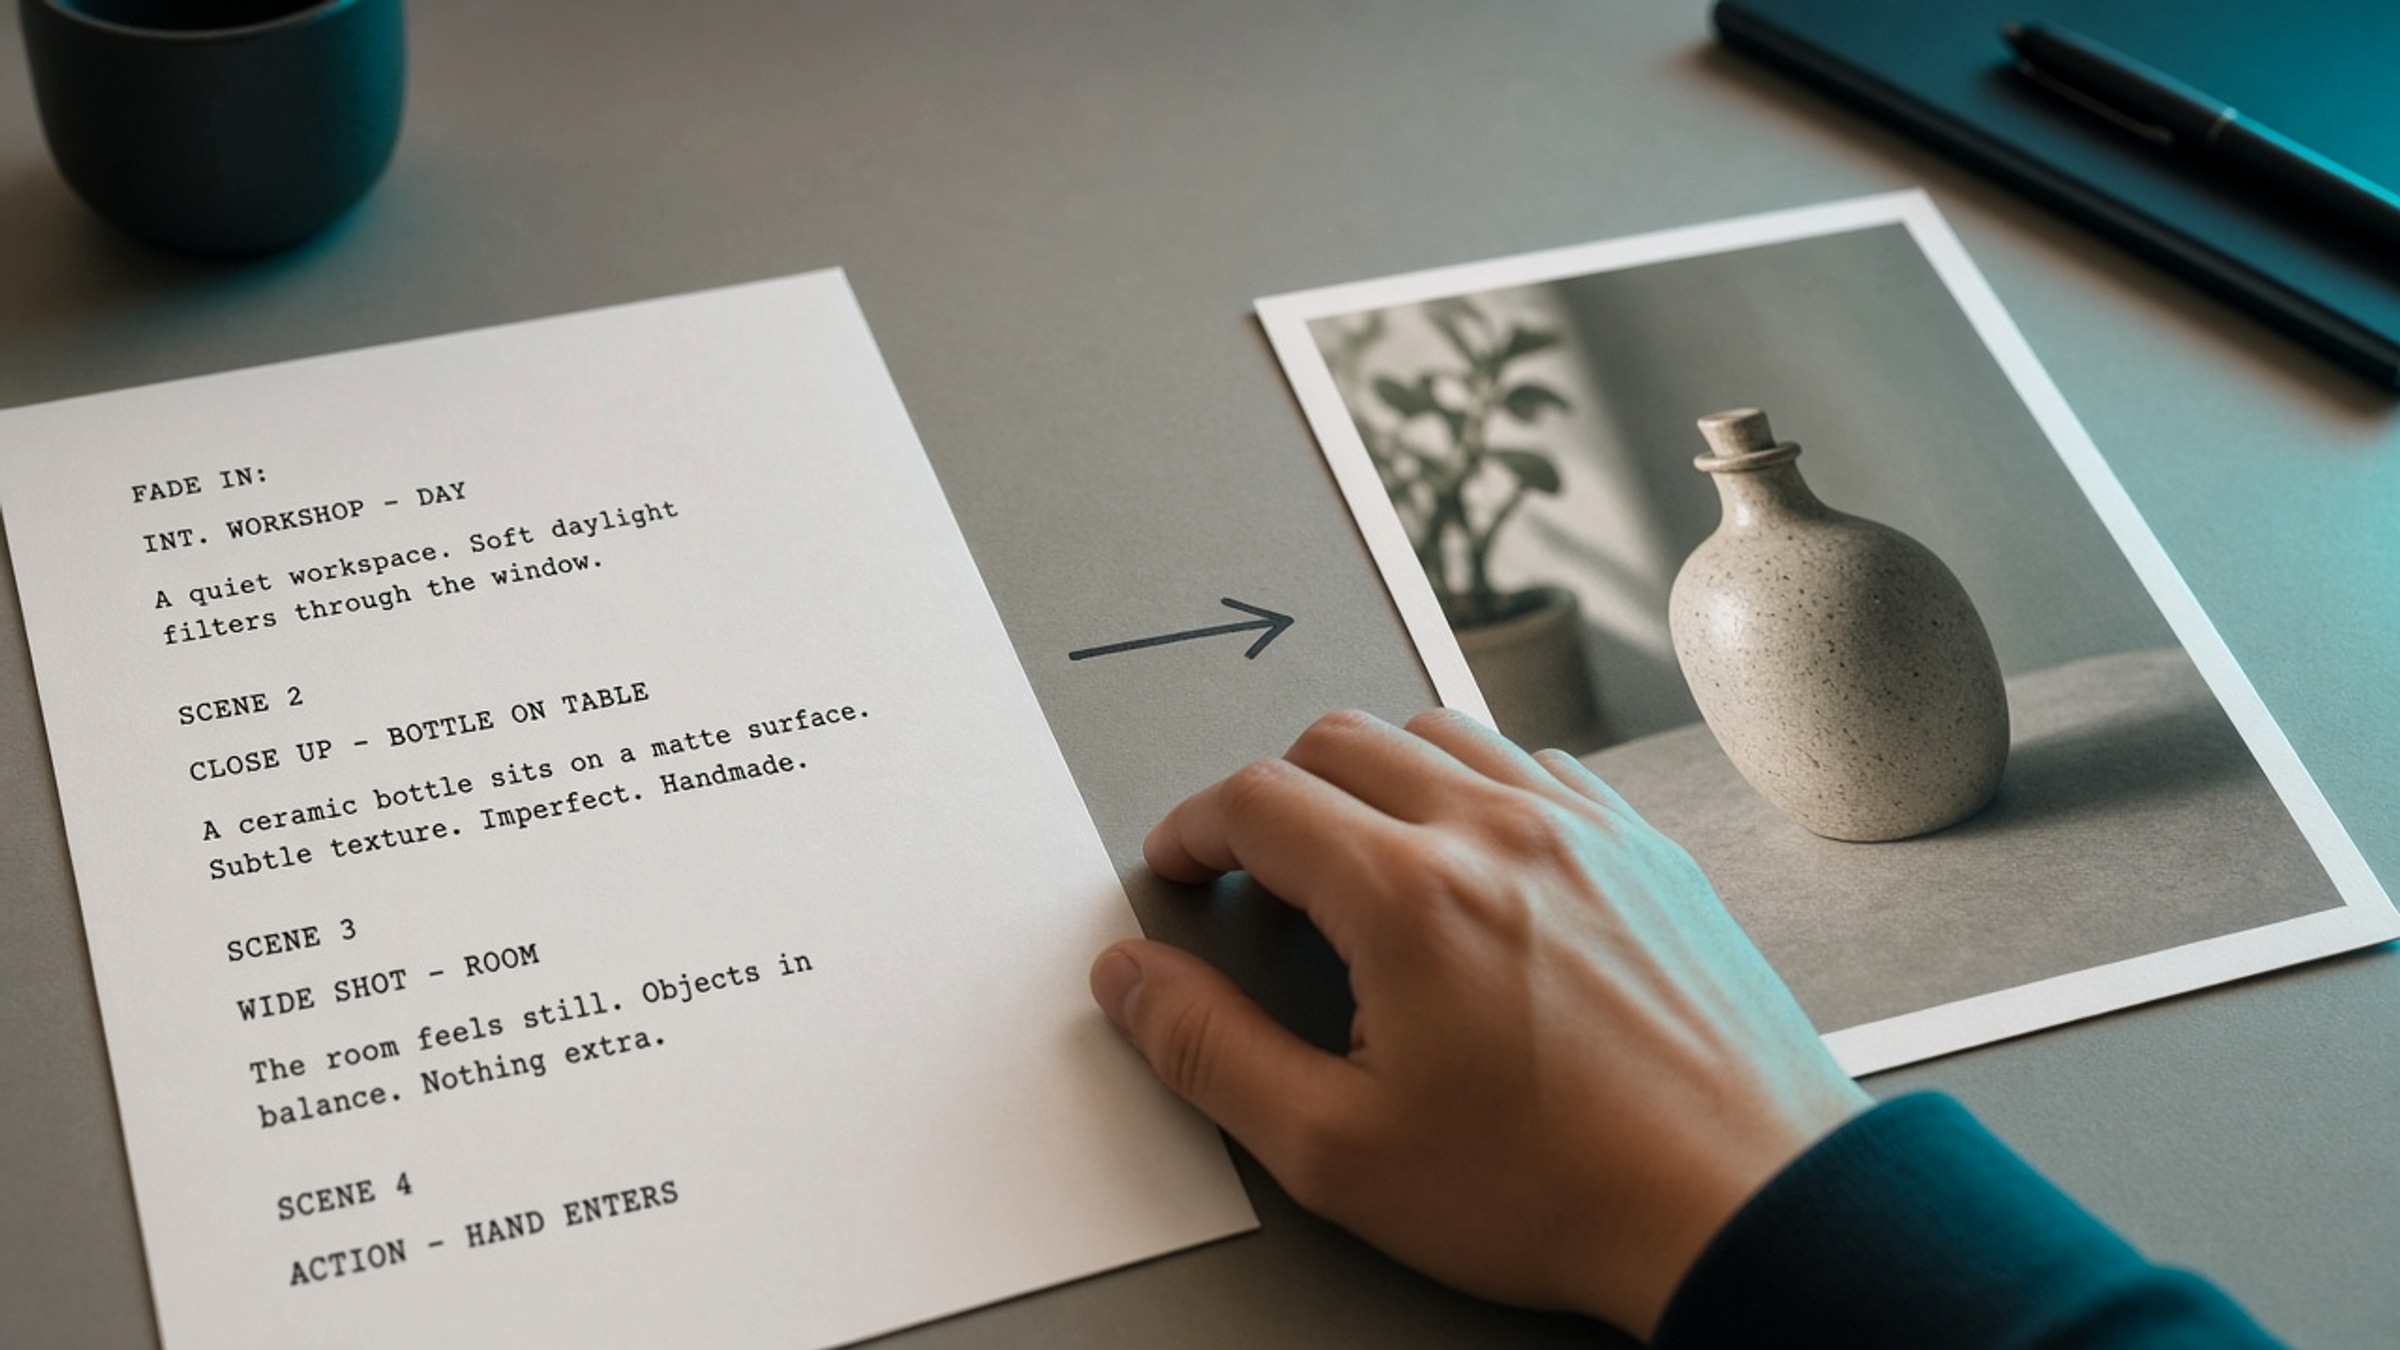
文生影片還是圖生影片? 先看手邊有沒有「已經認可的靜幀」。沒有,就用僅文字(text-to-video/t2v)快速試構圖;有,就用首幀(image-to-video/i2v,first frame)把外形鎖住,再補動作。需要明確的起訖畫面,或跨鏡頭要同一個人/同一包,再升到首尾幀或多模態參考(r2v)。輸入模式選錯,比重錯模型名稱更浪費重抽。在 Sora2 AI 也是先做這一步判斷。
用一張表選模式
| 你的起點 | 優先模式 | 提示詞寫什麼 | 常見翻車 |
|---|---|---|---|
| 只有文字想法 | 僅文字(t2v/文生影片) | 主體、動作、場景、一種運鏡、時長 | 堆了一串風格詞,卻沒有動詞 |
| 已有定稿產品或人物圖 | 首幀(i2v/圖生影片) | 怎麼動、鏡頭怎麼走 | 把長相又寫一遍,和靜幀衝突 |
| 開場和收束畫面都已知 | 首幀+尾幀 | 中間怎麼過渡、節奏多快 | 首尾畫幅差太大,動作幅度一次拉滿 |
| 跨鏡頭要同一角色或包裝 | 多模態參考(r2v) | 參考講清楚,一次只改一類變數 | 參考雜亂,前景擠太多人 |
口訣:開盲盒用文生;必須像某一版,就用圖生或參考。
文生影片:適合什麼、怎麼寫
適合敘事鉤子、氛圍鏡頭、還沒定妝的概念片、分鏡草稿。
依五段來排:主體 → 動作 → 場景 → 運鏡 → 時長用途。第一版只鎖定一種主運鏡,時長跟參數檔對齊,細節見 運鏡與時長。
圖生影片:適合什麼、怎麼寫
適合電商開品、角色定妝之後動起來、客戶已確認的包裝靜幀、海報動效。
提示詞少寫「這只紅色陶壺長什麼樣」,多寫「緩慢旋轉、蒸氣往上、鏡頭輕推」。參考圖主體要清楚,背景別搶戲;身份怎麼穩,見 參考幀一致性。
首尾幀和多模態,別跟首幀混用
- 首尾幀:時間軸兩端先釘死,適合你已經知道的轉場。尾幀比例對不齊時,多數管線會以首幀為準裁切。
- 多模態參考:鎖的是「是誰、什麼風格」,不是某一個時間起點。一次上傳多張,第一句就點名主參考,免得模型猜錯。
- 不要在同一支任務裡,又塞互相打架的首幀設定,又丟一整包無關參考。先定一種輸入契約。
少重抽的實作順序
- 先判斷:有沒有定稿靜幀?要不要跨鏡頭一致?
- 模式選定再寫提示詞(模式會告訴你哪些描述該刪)。
- 短時長先跑通,再加重運鏡或解析度。
- 人臉和產品包裝優先「靜幀 → 圖生」,少用純文生連抽賭臉。
- 對外投放前,過一遍 商用自查。
小結
文生影片負責「從無到有」,圖生影片負責「從有到動」;首尾幀與多模態參考處理轉場和身份。先選輸入模式,再依任務選模型族見 Seedance、Wan、Kling 怎麼選,重抽會少很多。
常見問題
文生影片和圖生影片差在哪?
文生影片(僅文字/t2v)用提示詞生出整段畫面;圖生影片(首幀/i2v,first frame)是在已定靜幀上補動作。前者試方向快,後者外形比較聽你的。
什麼情況一定要上首幀,不能只靠文字?
跨鏡頭要同一張臉、同一包裝、同一個 Logo 位置,或客戶已經簽過靜幀時,優先首幀。純文生比較適合概念片和分鏡草稿。
首幀和「首幀加尾幀」怎麼分?
只要「從這張圖接著演」→ 首幀。起點和終點都已知(白天到黃昏、開蓋到合蓋)→ 首尾幀。畫幅通常跟著首幀走,不必另外設一套預設比例。
多模態參考(r2v)算不算另一種首幀?
不算。首幀釘的是時間軸起點;多模態參考用多張圖穩住「是誰、什麼風格」,適合跨鏡頭一致。能吃幾張、怎麼吃,以當下模型能力為準。
圖生影片的提示詞還要再寫一次長相嗎?
少寫。圖已經告訴模型長什麼樣;提示詞改寫動作、運鏡、光線變化和這段時長要幹嘛,避免和靜幀互相打架。
單段時長多長比較不容易變形?
先用短檔確認主體不走樣,再加長。多數情況 4–8 秒比一次拉滿穩;長敘事用多段接,不要用一條提示詞賭一分鐘。
分享
相關文章
AI影片臉漂了?按症狀排查人物一致性
AI影片臉漂了怎麼修:先分片內漂、跨段漂、側臉漂與遮擋後漂,再按症狀改參考圖、縮短時長、降低動作幅度。對照表跑完一輪,多數一致性問題能定位。
工作流Seedance、Wan、Kling 怎麼選:依任務一次定族
Seedance、Wan、Kling 怎麼選:依長鏡、有聲短片、首尾幀與多模態參考對照三族。先定任務與輸入模式再進模型頁,少走重抽彎路,成片更貼需求。
工作流Sora2 AI 參考幀一致性:人物與產品怎麼穩住
用首幀、尾幀穩住 Sora2 AI 人物與產品一致性:何時切圖片轉影片、參考圖怎麼選、一次只改一類變數。按文中順序調參數,臉與包裝才守得住。